Inhaltsverzeichnis
Dein Dashboard für KI-Sichtbarkeit zeigt 32 %. Die Geschäftsführung ist zufrieden. Trotzdem stagniert der Traffic aus KI-Assistenten und im Sales hat noch niemand gehört, dass ein Lead ChatGPT erwähnt.
In der Regel lügt dabei niemand. Doch in den meisten Setups, die wir auditieren, ist die Zahl aufgebläht. Sie vermischt Fragen zu deiner eigenen Marke mit den Fragen, die potenzielle Kund:innen wirklich stellen. Sie kombiniert KI-Systeme, die deine Zielgruppe nutzt, mit solchen, die sie kaum nutzt. Und sie berichtet über Werte auf Markenebene, obwohl die eigentlichen Entscheidungen auf Produktebene fallen.
Dieser Artikel beantwortet vier Fragen, die jede Marketing-Führungskraft zu ihrem AI Visibility Reporting beantworten können sollte:
- Welche Metriken sind wirklich handlungsrelevant und welche sind Vanity Metrics?
- Wie misst mein Team KI-Sichtbarkeit heute?
- Sind die Daten, die ich sehe, aufgebläht?
- Was muss sich ändern, damit ich mit den Zahlen arbeiten kann?
Als Praxisbeispiel nutzen wir Peec AI, dazu echte, anonymisierte Daten von zwei B2B-Tech-Kunden.
Was ist KI-Sichtbarkeit?
KI-Sichtbarkeit (AI Visibility) beschreibt, wie oft, wo und wie deine Marke in Antworten von KI-Systemen wie ChatGPT, Google AI Overviews und AI Mode, Gemini oder Perplexity erscheint. Gemessen wird sie meist, indem ein festgelegtes Set an Prompts in regelmäßigen Abständen an diese Systeme geschickt wird. Die Antworten werden dann auf Markennennungen, Position, Sentiment und zitierte Quellen ausgewertet. KI-Sichtbarkeit ist ein Teil von Organic Growth, neben SEO, Content und der organischen Reichweite deiner Expert:innen.
TL;DR:
Das Wichtigste in Kürze
- KI-Sichtbarkeit ist eine Stichprobe, kein Ranking. Derselbe Prompt liefert je nach Durchlauf, Modell und Modus andere Antworten. Jede Zahl ist eine Schätzung und die Art der Stichprobe prägt das Ergebnis.
- Dein Prompt-Set kann dein Ergebnis erzeugen. In einem Kunden-Setup lieferten 11 Branded Prompts von 100 den Großteil der gesamten Markensichtbarkeit. Die gemischte Sichtbarkeit lag bei 11,7 %, bei Unbranded Prompts nur bei 0,85 %.
- Berichte Unbranded-Sichtbarkeit als zentralen KPI. Branded und Vergleichs-Prompts trackst du separat, und zwar für Korrektheit, Sentiment und Positionierung, nicht für Sichtbarkeit.
- Mische Modelle nicht blind. Dieselben Unbranded Prompts brachten einem Kategorie-Leader in ChatGPT 45 % Sichtbarkeit, in Perplexity aber nur 18 %.
- Miss dort, wo Entscheidungen fallen. Durchschnittswerte auf Markenebene verschleiern, dass du in einem Use Case führen und in einem anderen weit zurückliegen kannst.
- Verknüpfe Sichtbarkeit mit der Pipeline. Sonst hast du einen Score, der nur sich selbst bestätigt.
Wie funktioniert AI Visibility Tracking eigentlich?
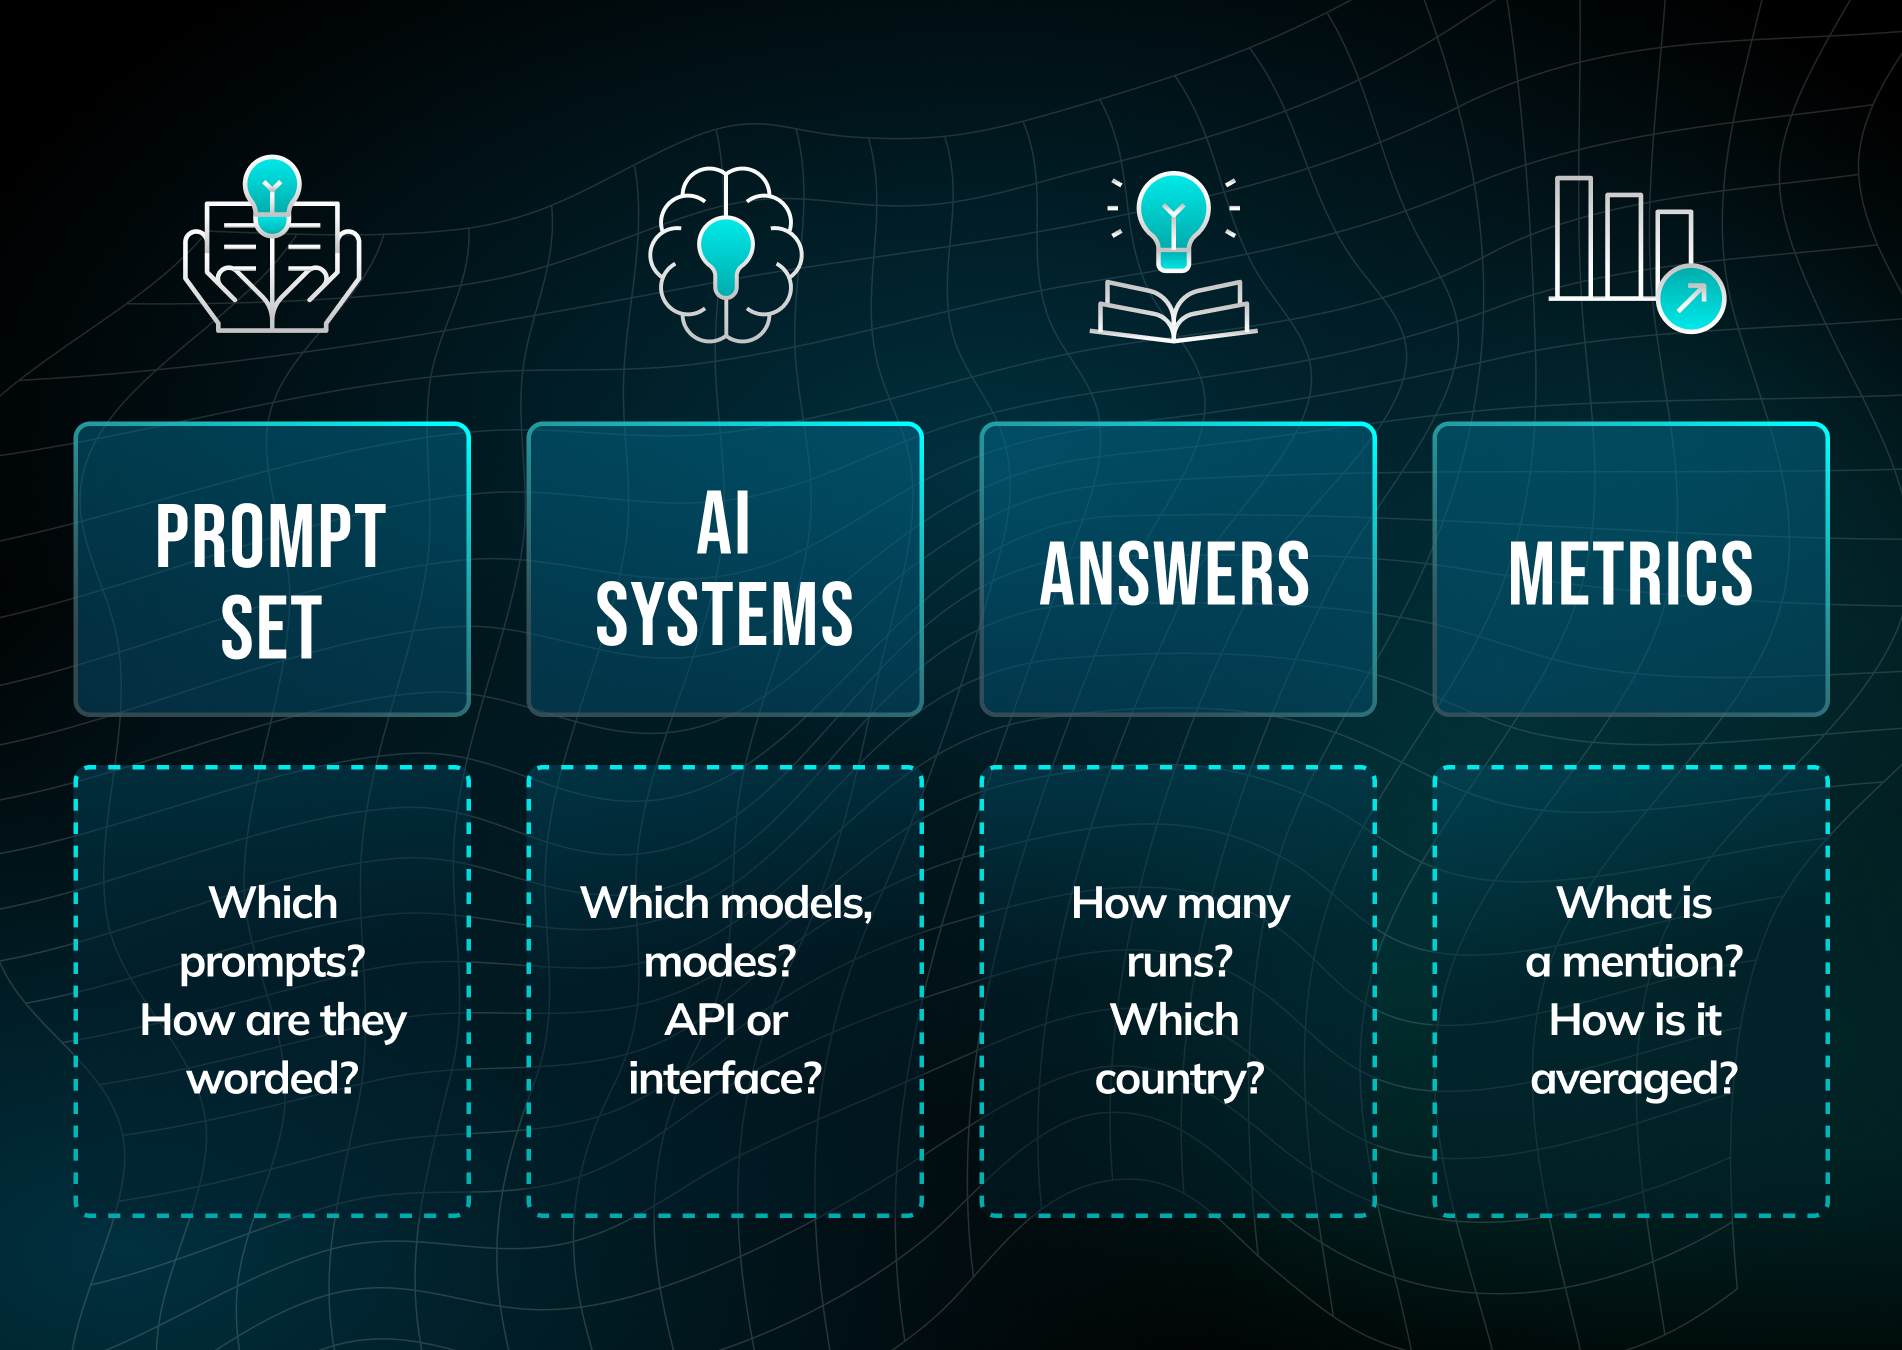
Bevor du den Zahlen vertraust, solltest du wissen, wie sie entstehen. Jeder Score für KI-Sichtbarkeit beruht auf ein paar Setup-Entscheidungen, die dein Team getroffen hat, oft ohne es zu merken.
Die meisten Prompt-basierten AI Visibility Tools folgen grob demselben Messablauf:
- Sie schicken ein definiertes Prompt-Set in festen Abständen an ausgewählte KI-Systeme.
- Sie speichern die vollständigen Antworten, inklusive zitierter Quellen, sofern die Plattform diese anzeigt.
- Sie werten jede Antwort auf Markennennungen, Listenposition, Sentiment und Quellen aus.
- Sie fassen die Ergebnisse zu Metriken über Prompts, Modelle, Länder und Zeiträume zusammen.
In Peec AI entsteht so ein Projekt mit deiner Marke und einem festgelegten Wettbewerbsset, einem Prompt-Set gegliedert in Topics und Tags, einer Auswahl an Modellen (zum Beispiel ChatGPT, Google AI Overviews und AI Mode, Gemini, Perplexity, Claude oder Copilot) sowie einem Land pro Prompt. Peec klassifiziert Prompts außerdem automatisch als Branded oder Non-Branded und nach Suchintention. Das wird später noch wichtig.
Klingt einfach. Die Probleme stecken in den Entscheidungen darunter.
Warum gibt es keine „genaue“ Zahl für KI-Sichtbarkeit?
KI-Systeme arbeiten probabilistisch. Derselbe Prompt im selben Tool am selben Tag kann eine andere Antwort, andere Marken und andere Quellen liefern. Personalisierung, Memory, Model Routing und die Suchschicht darunter sorgen für zusätzliche Schwankungen.
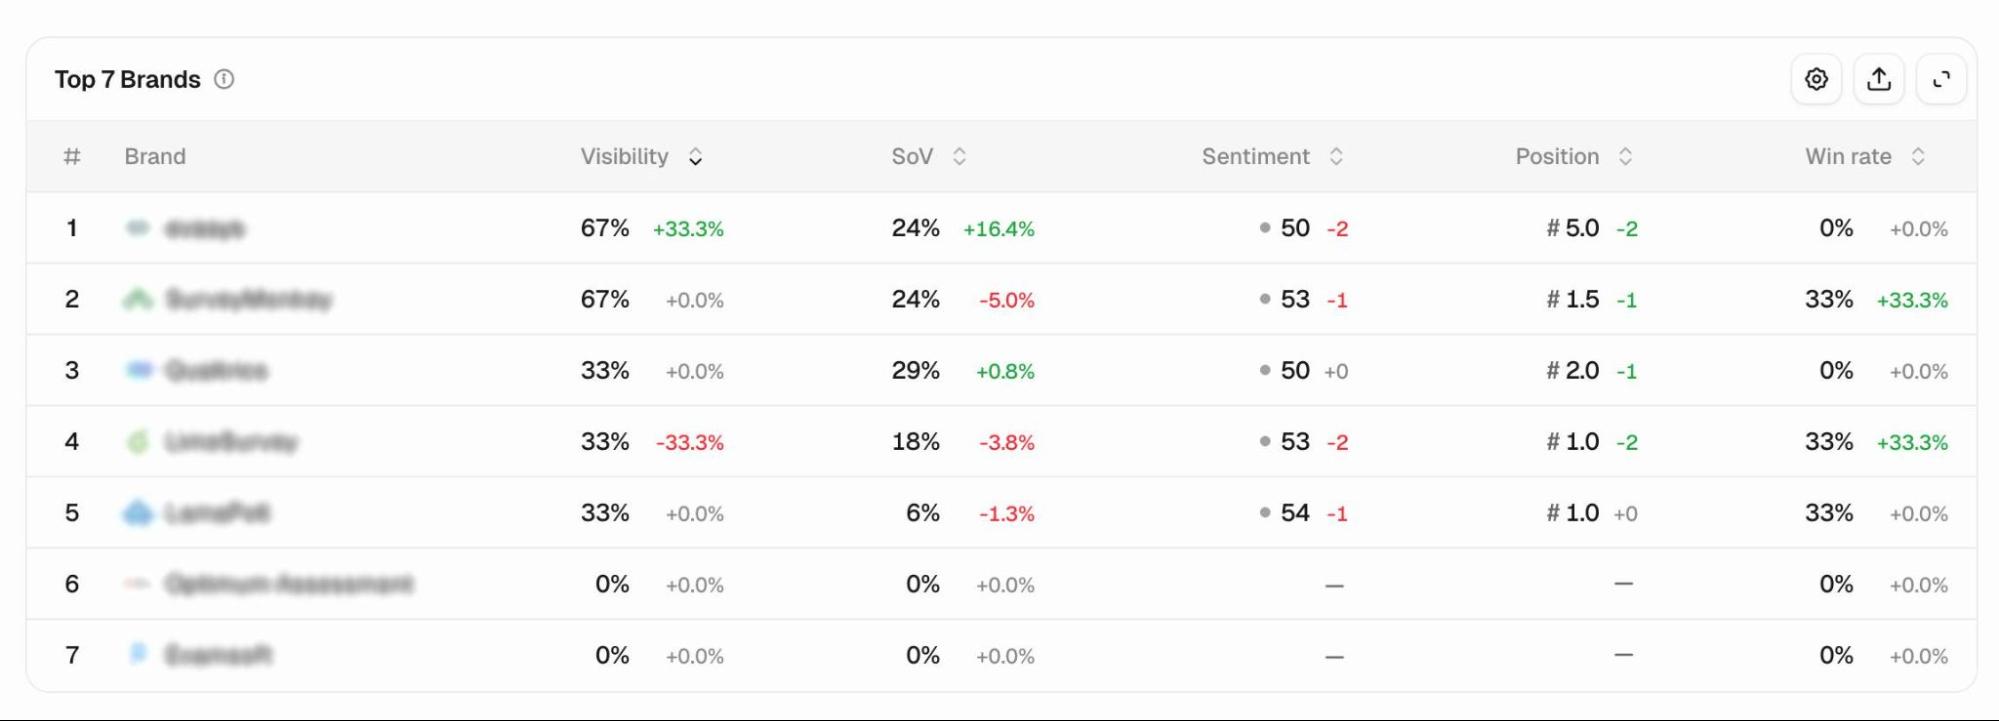
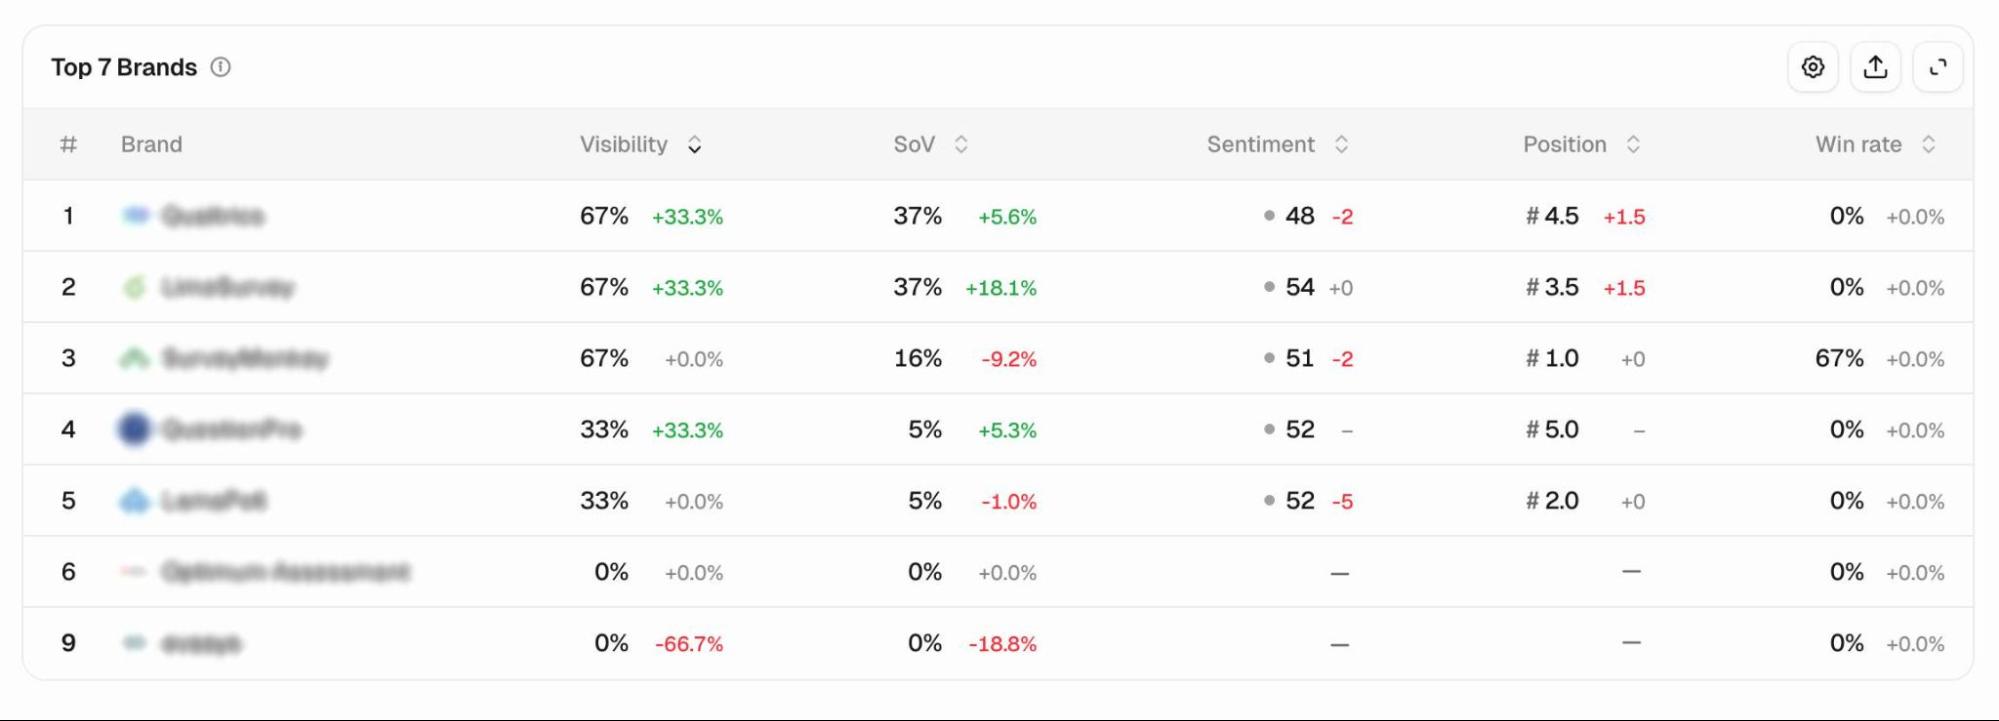
Beide Screenshots zeigen die Ergebnisse für denselben Prompt an zwei verschiedenen Tagen innerhalb derselben Woche.
Es gibt also keine einzige wahre Antwort, an der du messen kannst. Es gibt eine Verteilung möglicher Antworten und jedes Tracking-Tool zieht daraus eine Stichprobe. Mike King argumentiert genau so in seinem Beitrag über Genauigkeit vs. Präzision im AI Search Tracking: Wenn kein wahrer Wert existiert, kann ein Tool nicht genau sein. Es kann nur präzise sein, also unter gleichen Bedingungen konsistente Ergebnisse liefern.
Dadurch werden einige methodische Entscheidungen selbst Teil der Messung:
- API vs. Benutzeroberfläche: Ein Modell über die API abzufragen, ist nicht dasselbe System wie das Endprodukt, das deine Zielgruppe nutzt. Google bietet für AI Overviews und AI Mode aktuell keine vergleichbare öffentliche API für das Prompt Tracking durch Drittanbieter. Die Tools nutzen deshalb unterschiedliche Methoden, um Daten zu erheben oder anzunähern.
- Eingeloggt vs. ausgeloggt: Ausgeloggte Sessions vermeiden Personalisierung. Sie laufen aber unter Umständen auf einer anderen Modellkonfiguration als die, die die meisten echten Nutzer:innen sehen.
- Durchläufe pro Prompt: Eine Antwort pro Prompt und Zyklus ist ein Münzwurf, keine Messung. Erst mehrere Durchläufe machen aus einem Ja oder Nein eine Rate mit Fehlermarge.
- Modus: Der schnelle Modus und der Reasoning-Modus desselben Modells können ganz unterschiedliche Quellen zitieren. Eine Studie von Semrush fand zwischen dem Instant- und dem Thinking-Modus von ChatGPT nur rund ein Viertel überlappende zitierte Domains.
Ist eine präzise Zahl automatisch aussagekräftig?
Nein. Und diese zweite Falle bekommt deutlich weniger Aufmerksamkeit. Stabile Ergebnisse über mehrere Durchläufe beweisen, dass ein Setup konsistent ist. Sie beweisen aber nicht, dass das Prompt-Set abbildet, was echte Käufer:innen fragen, oder dass der Score irgendetwas vorhersagt.
Ein Tool kann dir eine sehr stabile, statistisch belastbare Zahl für ein Prompt-Set liefern, das wenig mit deinem Markt zu tun hat.
Meine Sicht: Behandle dein Setup für KI-Sichtbarkeit wie ein Forschungsinstrument, nicht wie ein Dashboard.
Welche Metriken gibt es und was sagen sie wirklich aus?
Keine einzelne Metrik für KI-Sichtbarkeit erzählt die ganze Geschichte. Jede beantwortet eine bestimmte Frage und führt auf bestimmte Weise in die Irre.
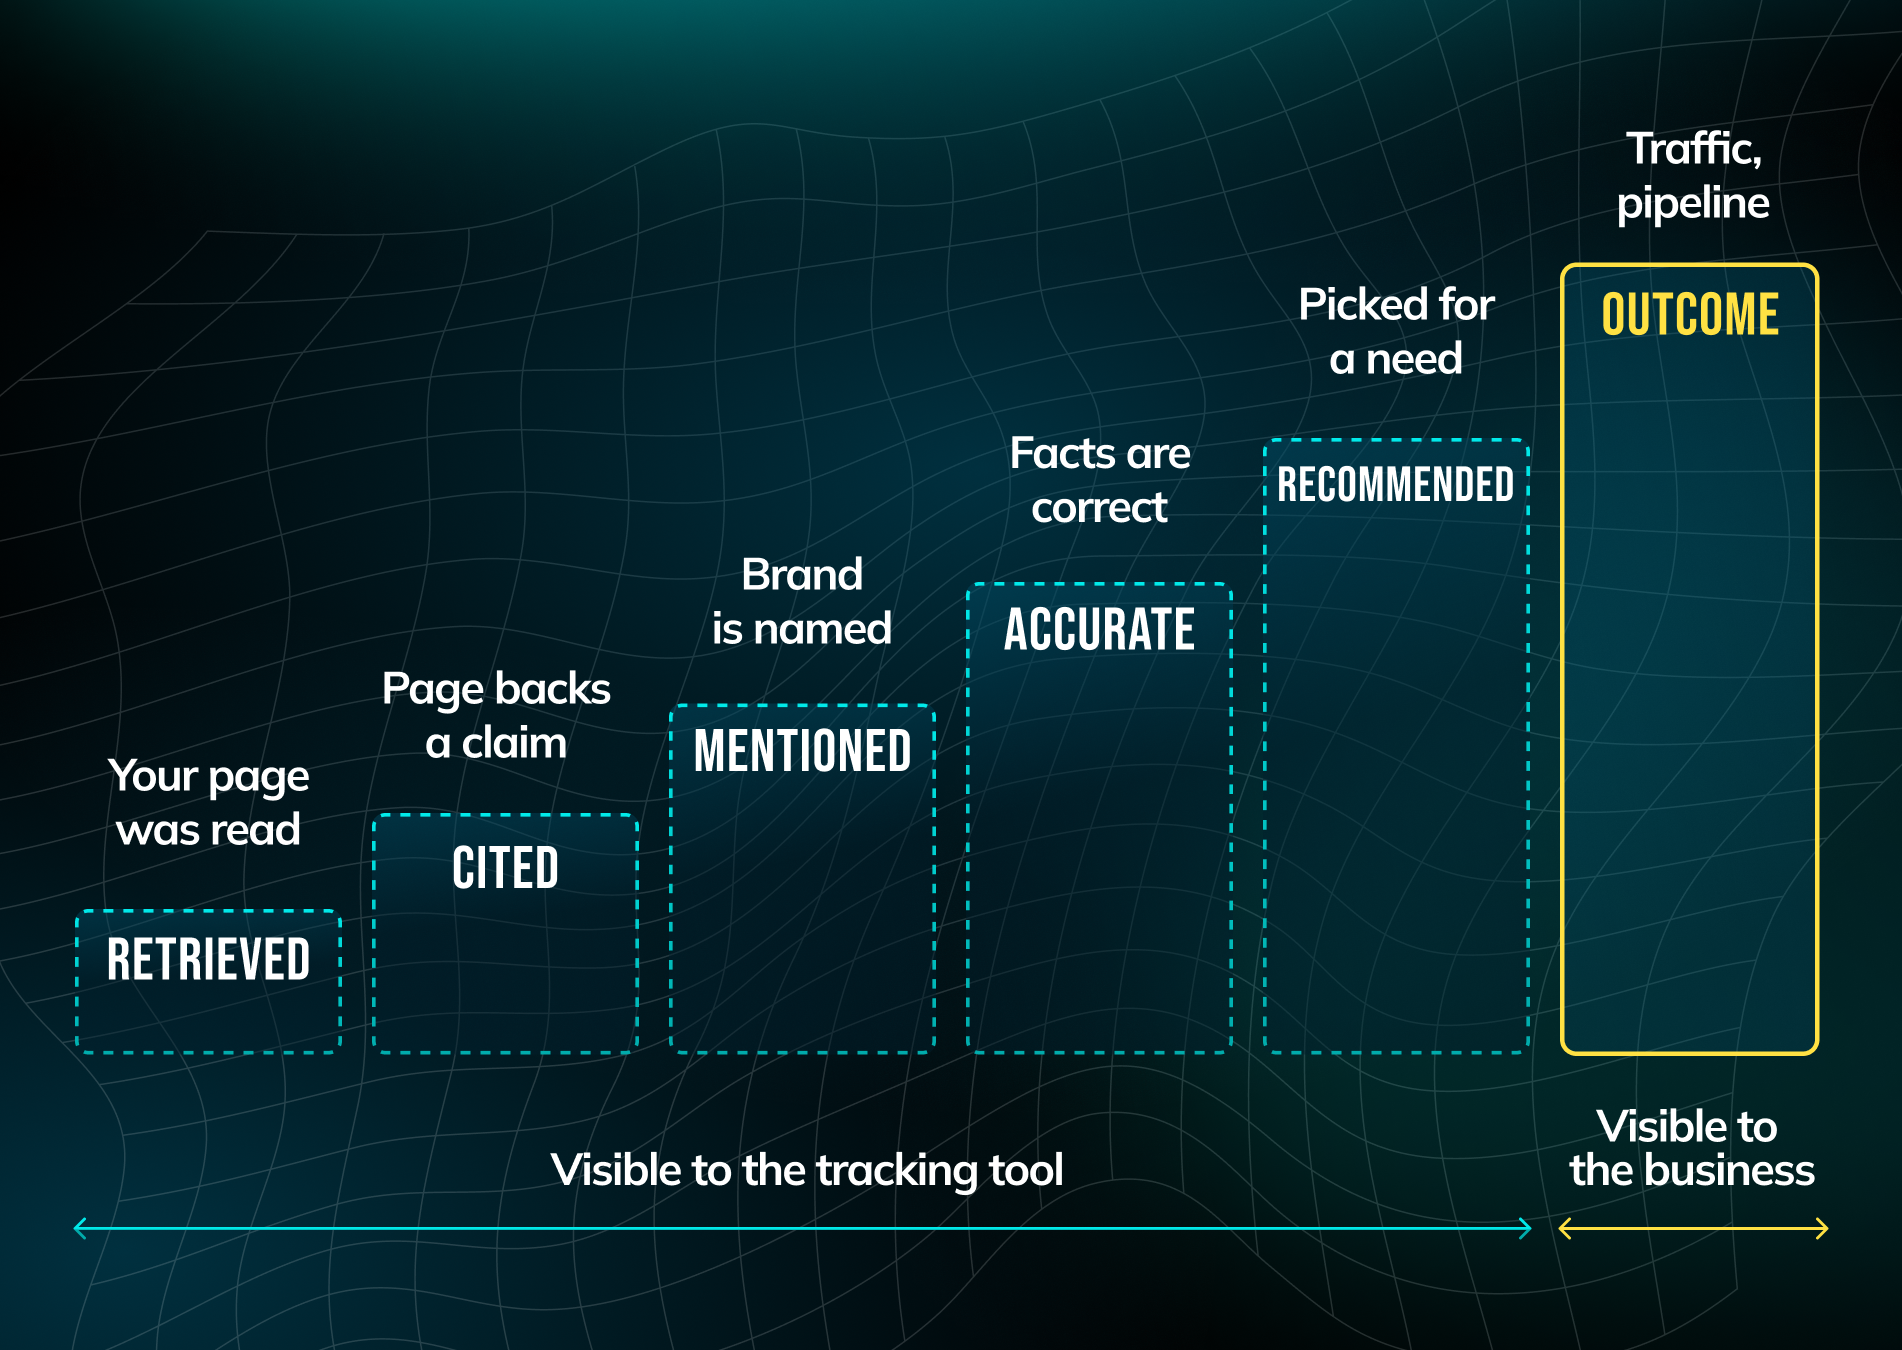
Starte mit einer einfachen Unterscheidung. Eine KI-Antwort kann deine Marke auf mehrere Arten einbeziehen und du kannst jede davon unabhängig gewinnen oder verlieren:
- Abgerufen (Retrieved): Das KI-System hat deine Seite in seinen Kontext geladen. Die Nutzer:innen sehen das nie.
- Zitiert (Cited): Deine Seite ist als Quelle für eine bestimmte Aussage verlinkt.
- Erwähnt (Mentioned): Dein Markenname taucht in der Antwort auf.
- Korrekt dargestellt: Was die Antwort über dich sagt, ist richtig und aktuell.
- Empfohlen: Du wirst für einen passenden Use Case vorgeschlagen, nicht nur aufgelistet.
- Mit einem Ergebnis verknüpft: Die Sichtbarkeit zeigt sich in KI-Referral-Traffic, Brand-Suchen, Demos oder Pipeline.
Suganthan Mohanadasans Analyse des Netzwerk-Traffics von ChatGPT zeigt, wie weit die ersten drei Stufen auseinanderliegen können. In seiner Stichprobe wurden YouTube-Seiten rund 200-mal abgerufen, aber kein einziges Mal zitiert. Herstellerseiten wurden oft für ihre eigenen Fakten zitiert, etwa für Preise. Die eigentliche Empfehlung stammte dagegen von externen Bewertungsplattformen. Daniel K Cheung ergänzt die späteren Stufen: Korrektheit, Empfehlung und Business-Ergebnis sind eigene Signale und sollten getrennt getrackt werden.
Die wichtigsten Metriken im Überblick
{start-table}
Metrik
- Sichtbarkeit (Visibility) (Anteil der KI-Antworten, die deine Marke nennen)
- Share of Voice (deine Nennungen als Anteil an allen Nennungen der getrackten Marken)
- Durchschnittliche Position (Rang, wenn du genannt wirst)
- Sentiment (Tonalität der Nennungen, 0 bis 100)
- Quellen-Metriken (wie oft deine Domains und URLs abgerufen und zitiert werden)
- Ergebnis-Metriken (KI-Referral-Traffic, Besuche von KI-Crawlern, selbstberichtete Attribution, Pipeline)
Welche Frage sie beantwortet
- Wie oft tauchen wir überhaupt in der Antwort auf?
- Wie viel der Konversation gehört uns im Vergleich zum Wettbewerb?
- Sind wir die erste Empfehlung oder eine Randnotiz?
- Wie werden wir beschrieben?
- Welche Seiten speisen die Antworten, unsere oder fremde?
- Kommt davon etwas im Business an?
Berechnung
- Sichtbarkeit = (Anzahl der Antworten mit deiner Marke / Gesamtzahl der Antworten) × 100
- SOV = (Anzahl der Nennungen deiner Marke / Gesamtzahl aller Markennennungen) × 100
-
-
-
-
Wann sie in die Irre führt
- Aufgebläht durch Prompts, die deine Marke oder Wettbewerber nennen. Über Modelle gemischt, verschleiert sie, wo du fehlst.
- Wird pro Nennung gezählt, deshalb blähen Antworten über dich den Wert auf. Der Nenner umfasst nur die Wettbewerber, die du ausgewählt hast.
- Wird nur berechnet, wenn du auftauchst. Eine seltene Nennung auf Platz 1 sieht deshalb hervorragend aus.
- Ein Durchschnittswert verdeckt einzelne falsche oder veraltete Aussagen.
- Abgerufen heißt nicht zitiert und zitiert heißt nicht empfohlen.
- Untererfasst, aber sie messen echte Ereignisse.
{end-table}
Zwei Fragen, die du vor jeder Metrik stellen solltest
Was ist die Einheit? Eine Nennung kann pro Antwort, pro Vorkommen innerhalb einer Antwort, pro Durchlauf oder pro Prompt gezählt werden. In Peec zählt die Sichtbarkeit Antworten, der Share of Voice dagegen Nennungen. Dieser Unterschied ist enorm wichtig, wie die nächsten Abschnitte zeigen.
Was ist der Nenner? Share of Voice ist dein Anteil an den Nennungen der Marken, die du trackst, nicht an allen Marken in den Antworten. Lässt du einen relevanten Wettbewerber weg, steigt dein Anteil, ohne dass sich im Markt irgendetwas verändert hat.
Warum unterscheidet sich KI-Sichtbarkeit je nach KI-System?
Dieselben Prompts erzeugen in verschiedenen KI-Systemen eine sehr unterschiedliche Sichtbarkeit. Ein gemischter Score verdeckt genau die Information, die du brauchst.
Jedes KI-System hat seine eigene Retrieval-Schicht, seine bevorzugten Quellen und eigene Gewohnheiten. Manche listen viele Anbieter auf, andere nennen nur wenige. Manche durchsuchen bei fast jeder kommerziellen Frage das Web, andere beantworten bestimmte Fragetypen allein aus ihren Trainingsdaten. Mehrere interne Tests von mir haben gezeigt, dass ChatGPT eine Frage erst klassifiziert, bevor es entscheidet, ob es überhaupt eine Websuche startet. Schon die Formulierung allein kann diese Entscheidung verändern.
So sieht das in der Praxis aus. Für Kunde A habe ich im September 2026 dieselben 89 Unbranded Prompts in vier KI-Systemen getrackt. Die Sichtbarkeit des Kategorie-Leaders pro System:
{start-table}
KI-System
- ChatGPT
- Google AI Overviews
- Gemini
- Perplexity
Sichtbarkeit des Kategorie-Leaders
- 44,9 %
- 41,0 %
- 35,6 %
- 17,6 %
{end-table}
Dieselben Prompts, derselbe Monat und trotzdem eine 2,5-fache Spanne. Kunde A selbst tauchte in 2,7 % der Antworten von AI Overviews und in 0,7 % der ChatGPT-Antworten auf. In Gemini und Perplexity erschien die Marke in keiner einzigen von jeweils 267 Antworten.
Wer all das zu einer Zahl mittelt, verliert die wichtigste Erkenntnis in den Daten: Die Marke ist in zwei von vier Systemen unsichtbar.
Drei Empfehlungen:
- Berichte zuerst pro Modell, dann gemischt. Eine gemischte Zahl ist eine Zusammenfassung, kein KPI.
- Gewichte Modelle danach, wo deine Zielgruppe ist. Wenn ChatGPT nachweislich auf deine Pipeline einzahlt, ist ein Rückgang der Sichtbarkeit in ChatGPT vermutlich deutlich wichtiger als ein Plus in Gemini.
- Halte die Modellauswahl stabil. Wenn du Fortschritt wirklich messen willst, wechsle die Modelle nicht ständig.
Prüfe außerdem, welchen Modus dein Tool abfragt. Wie oben beschrieben, können der schnelle und der Reasoning-Modus desselben Produkts auf ganz unterschiedliche Quellen zugreifen. Laut der Semrush-Studie startete der Thinking-Modus von ChatGPT mehr als viermal so viele Hintergrundsuchen wie der Instant-Modus, zitierte fast doppelt so viele Quellen pro Antwort und griff auf knapp 100 Domains zurück, die im Instant-Modus nie auftauchten.
Für die Messung heißt das: Ein Tool, das nur den schnellen Modus abfragt, übersieht womöglich genau die Quellen, die bei komplexen B2B-Evaluierungen zählen. Denn gerade dort greifen Käufer:innen eher zum Reasoning-Modus.
Meine Sicht: Für die meisten B2B-SaaS-Unternehmen, mit denen ich arbeite, decken drei oder vier Modelle die relevanten Käufer:innen ab. Jedes verfügbare Modell zu tracken, bringt selten zusätzliche Erkenntnisse. Es bringt aber zuverlässig mehr Rauschen und höhere Kosten.
{{cta}}
Wie baust du ein Prompt-Set, das sich zu messen lohnt?
Dein Prompt-Set bestimmt, was deine Zahl für KI-Sichtbarkeit bedeutet. Baue es aus echten Problemen deiner Zielgruppe, nicht aus deiner Keyword-Liste.
Prompts sind keine Keywords. Eine Keyword-Liste bildet näherungsweise die Suchnachfrage ab. Ein Prompt-Set ist eine Stichprobe der Fragen, die Käufer:innen einem KI-Assistenten stellen könnten. Und jeder Prompt, den du hinzufügst, verändert, wofür die finale Zahl steht.
Sinnvoller ist es, die Problemstellungen zu tracken, die für bestimmte Buyer Personas und Branchen relevant sind.
Die Formulierung verändert das Ergebnis stärker als gedacht
Kleine Unterschiede in der Formulierung verschieben die Ergebnisse deutlich. Im Prompt-Set von Kunde A behandeln zwei Prompts dasselbe Problem:
- „Wie können wir den Launch eines neuen Onlineshops vereinfachen?“ → Der Kategorie-Leader erscheint in 50 % der Antworten.
- „Warum ist der Launch eines neuen Onlineshops so zeitaufwendig?“ → 17 %
Die lösungsorientierte Formulierung zieht Anbieterempfehlungen an. Die problemorientierte Formulierung zieht Erklärungen an. Beides sind legitime Fragen von Käufer:innen, sie messen aber unterschiedliche Phasen der Buyer Journey.
Zähle Suchintentionen, nicht Prompt-Zeilen
Dasselbe Set enthielt außerdem vier fast identische Prompts dazu, wie man einen Onlineshop aufs neue Jahr vorbereitet. Hinter allen vieren steckt dieselbe Intention. Der Durchschnitt zählt sie trotzdem vierfach und wird dadurch aufgebläht.
Ein praxistauglicher Prozess
- Starte mit den Problemen deiner Zielgruppe. Sammle Problemstellungen aus Sales Calls, CRM-Notizen, Gründen für verlorene Deals, Support-Tickets und langen, fragebasierten Suchanfragen in der Google Search Console.
- Ordne jeden Prompt einer Persona und einer Phase im Kaufprozess zu. Zum Beispiel Problemerkennung, Lösungssuche und Anbieterauswahl. Tagge beides.
- Definiere Ist- und Soll-Zustand. Halte für jedes Topic fest, was KI-Antworten heute sagen und was sie sagen sollen. Diese Lücke ist deine Strategie.
- Trenne Branded und Unbranded Prompts vom ersten Tag an. Nutze separate Tags oder sogar separate Projekte. Warum, zeigt der nächste Abschnitt.
- Fasse Beinahe-Duplikate zusammen. Eine Intention sollte ein Prompt sein oder ein bewusst gestaltetes Cluster mit klarer Gewichtung.
- Formuliere realistisch. Schreibe Prompts so, wie Käufer:innen mit einem KI-Assistenten sprechen, mit Kontext und Rahmenbedingungen, nicht wie eine Suchanfrage aus drei Wörtern.
- Friere das Kern-Set ein. Überprüfe es monatlich oder quartalsweise, nicht wöchentlich, und dokumentiere jede Änderung.
Wie kann dein Prompt-Set dein Ergebnis verfälschen?
Prompts, die deine Marke nennen, erzeugen Antworten, die deine Marke nennen. Im selben Report vermischt, lassen sie eine fast unsichtbare Marke wie einen Kategorie-Leader aussehen.
Das ist der häufigste Setup-Fehler, den ich sehe, und der teuerste. Denn er produziert genau die Zahlen, die alle sehen wollen.
Vergleichs-Prompts wie „[Deine Marke] vs. [Wettbewerber]“ oder Fragen wie „Eignet sich [Deine Marke] für den Enterprise-Handel?“ nennen deine Marke fast immer. Das ist keine Sichtbarkeit. Die Person hat schließlich nach dir gefragt.
Wie das in echten Daten aussieht
Kunde A trackt 100 Prompts in vier KI-Systemen. 11 davon nennen die Marke: Vergleiche, Eignungsfragen und Fragen zu Funktionen. Im September 2026 führten diese 11 Prompts in jeder einzelnen Antwort zu einer Nennung. So verändern sie die zentralen Kennzahlen:
{start-table}
Metrik
- Sichtbarkeit
- Share of Voice
- Durchschnittliche Position
Alle Prompts (gemischt)
- 11,7 %
- 25,6 % (Rang 2 von 12 Marken)
- 1,2 %
Nur Unbranded Prompts
- 0,85 %
- 0,9 % (Rang 8 von 12 Marken)
- 3,0 %
{end-table}
11 % der Prompts erzeugten 94 % der Sichtbarkeit und 98 % aller Markennennungen.
Im gemischten Dashboard wirkt die Marke wie die Nummer zwei ihrer Kategorie, meist an erster Stelle genannt. Bei den Fragen, die Käufer:innen stellen, bevor sie die Marke kennen, taucht sie in weniger als einer von 100 Antworten auf.
Warum der Share of Voice noch stärker aufgebläht wird
Sichtbarkeit zählt Antworten, Share of Voice zählt Nennungen. Eine Antwort über deine Marke nennt sie immer wieder: Die Branded-Antworten von Kunde A enthielten im Schnitt sieben Nennungen. In einer Unbranded-Antwort mit zehn Anbietern bekommst du bestenfalls eine.
Branded Prompts blähen den Share of Voice deshalb noch stärker auf als die Sichtbarkeit. Bei Kunde A war der gemischte Share of Voice fast 30-mal höher als der Unbranded-Wert.
Die subtilere Variante: Prompts, die Wettbewerber nennen
Kunde B hat ein ausgewogeneres Setup. Antworten auf die eigenen Branded Prompts machen nur rund 9 % der Daten aus. Trotzdem:
- Gemischte Sichtbarkeit: 32,0 %
- Ohne Prompts mit der eigenen Marke: 25,6 %
- Zusätzlich ohne Prompts, die Wettbewerber nennen: 21,4 %
Den letzten Schritt übersieht man leicht. Prompts wie „die besten Alternativen zu [Wettbewerber]“ werden automatisch als Non-Branded klassifiziert, weil sie deinen Markennamen nicht enthalten. Für jemand anderen sind sie aber sehr wohl Branded. In diesem Cluster tauchte der genannte Kategorie-Leader in 85 % der Antworten auf und Kunde B in 48 %, mit Abstand sein stärkstes Topic. Das Cluster bläht also beide Marken auf.
Die Lösung
- Berichte Unbranded-Sichtbarkeit als zentralen KPI. Nur diese Zahl zeigt, ob KI-Systeme dich Menschen empfehlen, die dich noch nicht kennen.
- Tagge jeden Prompt, der eine Marke nennt, deine oder die eines Wettbewerbers, und prüfe die automatische Klassifizierung manuell.
- Nutze Branded Prompts für das, was sie gut können: Korrektheit, Sentiment, Positionierung und Einwände. Wird dein Preismodell richtig beschrieben? Wird eine eingestellte Funktion noch erwähnt? Mit welchem Wettbewerber wirst du verglichen und nach welchen Kriterien?
- Stelle eine gemischte Zahl nie neben die Zahlen deiner Wettbewerber. Deine Branded Prompts pushen dich, nicht sie. Der Vergleich ist also von Anfang an zu deinen Gunsten verzerrt.
Meine Sicht: Wenn ein Dashboard deine Marke vor dem Marktführer zeigt, prüfe das Prompt-Set, bevor du feierst. Die Lücke zwischen gemischter und Unbranded-Sichtbarkeit ist die erste Zahl, die ich mir in jedem AI Visibility Audit anschaue.
Wie misst du KI-Sichtbarkeit auf Produkt- und Service-Ebene?
Eine Sichtbarkeitszahl auf Markenebene mittelt genau die Entscheidungen weg, die du eigentlich treffen musst.
Die meisten B2B-SaaS-Unternehmen verkaufen nicht ein Produkt an eine Zielgruppe. Sie haben Produktlinien, Use Cases, Segmente und Märkte, jeweils mit eigenem Wettbewerbsumfeld. Eine einzige Zahl auf Markenebene sagt über keinen dieser Bereiche viel aus.
Der Durchschnitt auf Markenebene hätte zu einer pauschalen Initiative geführt, die „KI-Sichtbarkeit zu verbessern“. Die Aufschlüsselung zeigt uns, wo genau: zum Beispiel bei der frühen Discovery-Phase und bei hybriden Workflows, nicht bei den Themen Kosten und Vergleich, die man aus dem Bauch heraus vielleicht priorisiert hätte.
So setzt du es auf
- Ein Topic pro Produktlinie oder Use Case. In Peec eignen sich Topics gut für die Hauptaufteilung, da jeder Prompt genau einem Topic zugeordnet ist. Für übergreifende Dimensionen wie Persona, Phase im Kaufprozess, Markt und Priorität nutzt du Tags.
- Nutze produktspezifische Wettbewerbssets. Dein Wettbewerber für das eine Produkt ist oft nicht dein Wettbewerber für das andere. Share of Voice ist nur gegenüber dem richtigen Set aussagekräftig.
- Ordne zitierte URLs den richtigen Seiten zu. Prüfe pro Topic, welche deiner Seiten abgerufen und zitiert werden. Wenn Antworten zu einem Produkt deine Startseite oder die Vergleichsseite eines Wettbewerbers zitieren statt deiner Produktseite, hast du eine Content- oder Strukturlücke.
- Tracke Märkte getrennt. Derselbe Prompt in Deutschland und in den USA sind zwei verschiedene Messungen, oft mit ganz anderen Quellen dahinter.
So liest du die Daten, ohne dich selbst zu täuschen
Daten zur KI-Sichtbarkeit sind von Natur aus verrauscht. Das Ziel ist nicht nur, das Rauschen zu reduzieren, sondern auch, nicht mehr darauf zu reagieren.
Validiere mit echten Ergebnissen
Die einzigen echten Zahlen in diesem System liegen außerhalb des Tracking-Tools: KI-Referral-Sessions, Besuche von KI-Crawlern und KI-Agenten in deinen Logfiles, Brand-Suchvolumen, Antworten auf „Wie bist du auf uns aufmerksam geworden?“ und Pipeline. Diese Werte sind untererfasst, beschreiben aber Ereignisse, die tatsächlich stattgefunden haben.
Steigt deine Sichtbarkeit sechs Monate lang und keine dieser Kennzahlen bewegt sich, liegt das Tool nicht zwingend falsch. Vielleicht misst es Prompts, die für dein Business keine Rolle spielen. Und das ist eine noch wichtigere Erkenntnis.
Review-Rhythmus
- Wöchentlich: Korrektheit der Antworten auf Branded Prompts und offensichtliche Fehler
- Monatlich: Unbranded-Sichtbarkeit pro Modell und Topic, Quellen und Lücken bei Zitierungen
- Quartalsweise: Prompt-Set, Topic-Struktur, Wettbewerbsset und Modellauswahl
- Laufend: KI-Referral-Traffic, Brand-Suchen und Pipeline als Validierungsebene
8 Fragen, bevor du einem Dashboard für KI-Sichtbarkeit vertraust
Du brauchst kein Statistikstudium, um ein Setup für KI-Sichtbarkeit zu beurteilen. Du musst nur die richtigen Fragen stellen, deinem Tool-Anbieter und deinem eigenen Team.
David McSweeneys 31 Fragen sind eine der gründlichsten Methodik-Checklisten, die ich kenne. Es lohnt sich, sie komplett zu lesen. Hier eine verdichtete Version für Führungskräfte, die eine Zahl im Meeting einordnen müssen:
- Auf wie vielen Durchläufen pro Prompt basiert diese Zahl? Ein Durchlauf pro Prompt und Zyklus ist eine Momentaufnahme, keine Rate.
- Welche Modelle und Modi sind enthalten und wie werden sie kombiniert? Gleich gewichtet, nach Nutzung gewichtet oder einfach nach der Anzahl der Prompts pro Modell?
- Welcher Anteil der Prompts nennt unsere Marke oder einen Wettbewerber? Und fließen diese Prompts in die zentrale Kennzahl ein?
- Was zählt als Nennung? Antworten, Vorkommen oder Links? Wie werden Produktnamen, Aliasse und mehrdeutige Markennamen behandelt?
- Was ist der Nenner beim Share of Voice? Alle genannten Marken oder nur die Wettbewerber, die wir ausgewählt haben?
- Wie werden fehlgeschlagene oder leere Antworten gezählt? Wenn ein Modell die Antwort verweigert, in einen Timeout läuft oder keine Suche startet, gilt das als „nicht sichtbar“ oder wird es ausgeschlossen?
- Sind Änderungen am Setup in den Trend-Charts markiert? Neue Prompts, Modell-Updates, geänderte Extraktionsregeln?
- Wurde der Score jemals mit einer externen Größe abgeglichen? Zum Beispiel KI-Referral-Traffic, Brand-Suchen oder Pipeline. Ein Score, der nur an sich selbst validiert wurde, ist noch keine Messung.
Lorem ipsum dolor sit amet
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Suspendisse varius enim in eros elementum tristique.
Gute Sichtbarkeitszahl, aber kaum Wirkung in der Pipeline?
Unsere Organic-Growth- und Content-Expert:innen finden mit dir heraus, wo deine Buyer in KI-Antworten wirklich nach dir suchen, und bauen die Content-Strategie, die dich dort sichtbar macht.
Fazit
Erst das Setup messen, dann die Marke
AI Visibility Tracking lohnt sich, aber nur, wenn das Setup hinter der Zahl vertrauenswürdig ist.
Tracking ist eine der wenigen Möglichkeiten zu sehen, wie KI-Systeme deine Kategorie beschreiben, welche Wettbewerber sie mit den Problemen deiner Zielgruppe verbinden und welche Quellen diese Antworten prägen.
Doch die Zahl ist nur so gut wie ihr Design. Prompts mit deinem Markennamen blähen sie auf. Gemischte Modelle verdecken, wo du fehlst. Einzelne Durchläufe machen aus Rauschen vermeintliche Trends. Durchschnittswerte auf Markenebene verschleiern Entscheidungen auf Produktebene.
Bevor du KI-Sichtbarkeit also an deinen Vorstand berichtest, stell sicher, dass du erklären kannst, wofür die Zahl steht. Trenne Branded von Unbranded. Berichte pro Modell und pro Produkt. Zähle Intentionen, nicht Zeilen. Und verknüpfe die Zahl mit etwas, das außerhalb des Tools passiert.
Das Ziel ist kein hoher Score. Das Ziel ist ein Score, mit dem du Entscheidungen treffen kannst.
Deine Fragen, unsere Antworten
Ist AI Visibility Tracking genau?
Nicht im klassischen Sinn, denn es gibt keine einzige wahre Antwort, an der man messen könnte. KI-Systeme erzeugen je nach Durchlauf, Modell und Nutzer:in unterschiedliche Antworten. Ein gutes Setup liefert aber eine konsistente, wiederholbare Messung auf Basis eines gut durchdachten Prompt-Sets, validiert an echten Ergebnissen wie KI-Referral-Traffic und Pipeline.
Wie viele Prompts solltest du tracken?
Eine universelle Zahl gibt es nicht. Wichtiger ist, wie viele unabhängige Suchintentionen deiner Zielgruppe dein Set abdeckt und wie oft jeder Prompt läuft. Für die meisten B2B-SaaS-Unternehmen, mit denen ich arbeite, sind 50 bis 150 gut gestaltete Prompts ein praktikabler Rahmen, aufgeteilt nach Produkt, Persona und Phase im Kaufprozess. Ein kleineres Set mit mehr Durchläufen pro Prompt ist meist nützlicher als ein großes Set mit jeweils nur einem Durchlauf.
Solltest du Branded und Vergleichs-Prompts überhaupt tracken?
Ja, aber getrennt. Branded und Vergleichs-Prompts sind wertvoll, um Korrektheit, Sentiment und Positionierung zu prüfen und zu sehen, wie du im Vergleich zum Wettbewerb dargestellt wirst. In deine zentrale Sichtbarkeitskennzahl gehören sie nicht. Denn Antworten auf Fragen zu deiner Marke nennen sie fast immer.
Welche KI-Systeme solltest du tracken?
Starte mit den Systemen, die deine Zielgruppe tatsächlich nutzt. Dein KI-Referral-Traffic nach Quelle ist dafür ein guter Indikator. Für die meisten B2B-Unternehmen sind das ChatGPT und Google AI Overviews oder Claude. Besteht der ICP aus klassischen europäischen Konzernen, nehme ich zusätzlich Microsoft Copilot dazu. Berichte jedes System einzeln, bevor du dir eine gemischte Zahl ansiehst.
Wie verknüpfst du KI-Sichtbarkeit mit der Pipeline?
Behandle Sichtbarkeit als Frühindikator (Leading Indicator) und validiere sie mit Spätindikatoren (Lagging Indicators): KI-Referral-Sessions und Conversions, Brand-Suchvolumen, selbstberichtete Attribution in Formularen und Sales Calls sowie Influenced Pipeline. Bewegen sich Sichtbarkeit und diese Signale über längere Zeit nicht gemeinsam, überarbeite zuerst dein Prompt-Set und erst danach deinen Content.